ARCHITECTURE ANALYSIS
算力增长遭遇‘内存墙’与‘互连墙’:异构Chiplet封装已成唯一解法
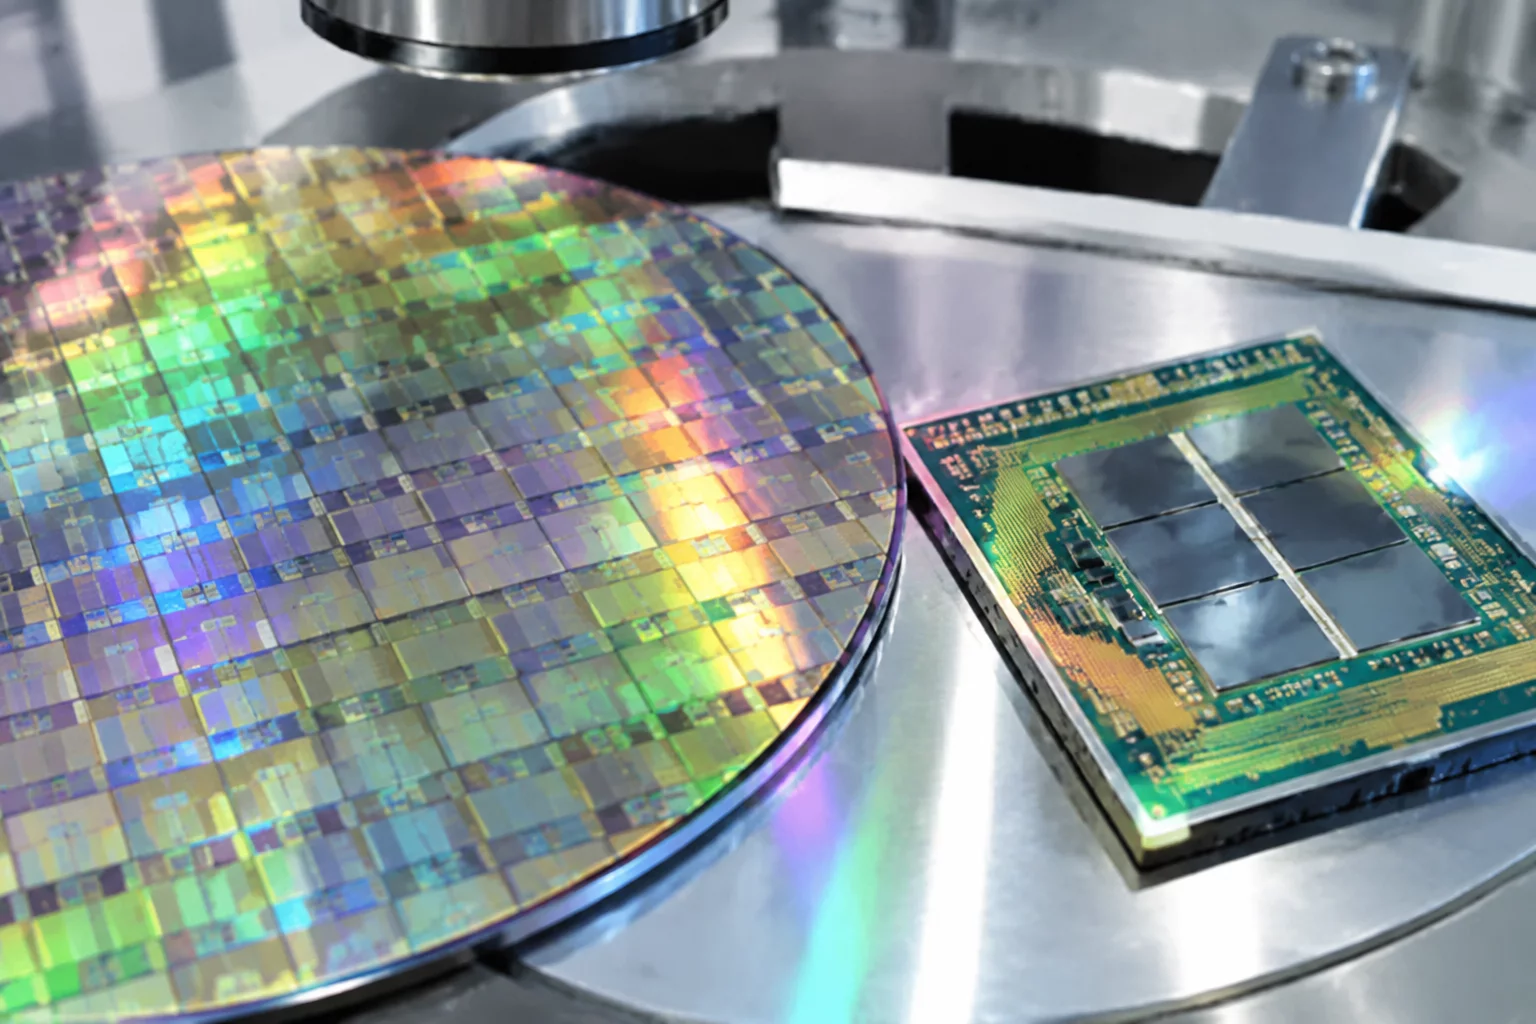
在SEMICON Taiwan 2026主题演讲中,半导体工程院与产业界代表明确指出,当前大模型训练与推理集群的核心瓶颈已从单纯的计算单元吞吐量,转向芯片之间、模组之间的数据搬运带宽。随着单颗Die面积逼近光罩极限(Reticle Limit),继续依靠单片微缩提升性能的道路越发艰难。将逻辑计算单元、高带宽内存(HBM4)与I/O控制器拆解为模块化Chiplet小芯片,并通过微米级微凸点与硅中介层紧密重构,已成为支撑下一代千卡、万卡集群的必由之路。
峰会展示的数据显示,当前顶尖AI加速器内部,计算芯片与HBM之间的数据搬运所消耗的电力已经占据整卡总功耗的近35%。台积电在会上公布了其强化版CoWoS-L以及第二代A16制程的晶圆背面供电集成进展,通过在无源中介层中嵌入高密度深沟槽电容与光学互连小芯片,成功将信号走线延迟压低了40%以上,同时大幅缓解了高密度瞬态电流带来的压降问题。
“当算力密度每两年翻倍而引脚铜线互连物理特性受限时,谁能率先在封装基板内打通光子链路,谁就能掌握下一个十年的算力底座主导权。”
光电共封装CPO与玻璃基板:突破下代带宽密度的关键技术路线
除了成熟的硅基中介层技术,本次峰会最受热议的焦点莫过于玻璃芯基板与光学共封装(Co-Packaged Optics, CPO)的商业化时间表。传统有机基板在极高布线密度和数百瓦瞬时热负荷下容易发生翘曲微裂纹,而玻璃基板具备更优异的平整度、更低的热膨胀系数以及更高的耐电迁移特性,能容纳更加密集的细微通孔。
- 硅光互连模块微型化:将800G乃至1.6T光学收发引擎直接集成至算力芯片周边数毫米内,省去传统长距离高速电信号损耗补偿电路。
- 玻璃芯基板通孔加工精度飞跃:TGV间距缩减至15微米以下,为HBM4超宽数据总线提供极低寄生电容的高速通路。
- 标准化UCIe与异构互连生态:包括联发科、日月光在内的企业正加速推进通用Chiplet互连标准,降低多厂商异构模块混装的物理层验证门槛。
根据产业链交流透露,随着测试设备与光学对准良率的持续攀升,预计在2027年上半年,采用定制玻璃基板与直接光纤直连中继的商用AI超算模组将进入规模量产试样阶段。这将为云端超算中心提供更高的每瓦吞吐量,同时让服务器机柜内部不再受制于繁杂的铜线缆积聚与风阻难题。
峰会议题讨论与架构研讨
暂无技术研讨评论。欢迎经过实名认证的实验室评测员留下第一条见解。
为了维护专业客观的技术研讨氛围,仅已实名验证的认证架构师与评测员可发表新评论。如需留言请先登录您的实验室账户。